輝達Vera押注單執行緒效能 AI代理挑戰Chiplet時代設計思維
記者黃仁杰/編譯
隨著代理式AI(Agentic AI)快速發展,輝達認為資料中心CPU的設計邏輯正在出現反轉。過去雲端時代追求的是「塞進更多核心」,但AI代理需要CPU與GPU之間高速往返,因此單執行緒效能、記憶體頻寬與低延遲重新變得重要。
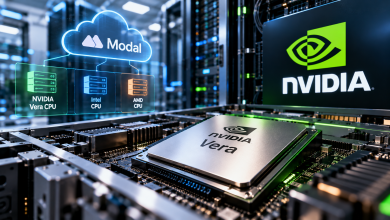
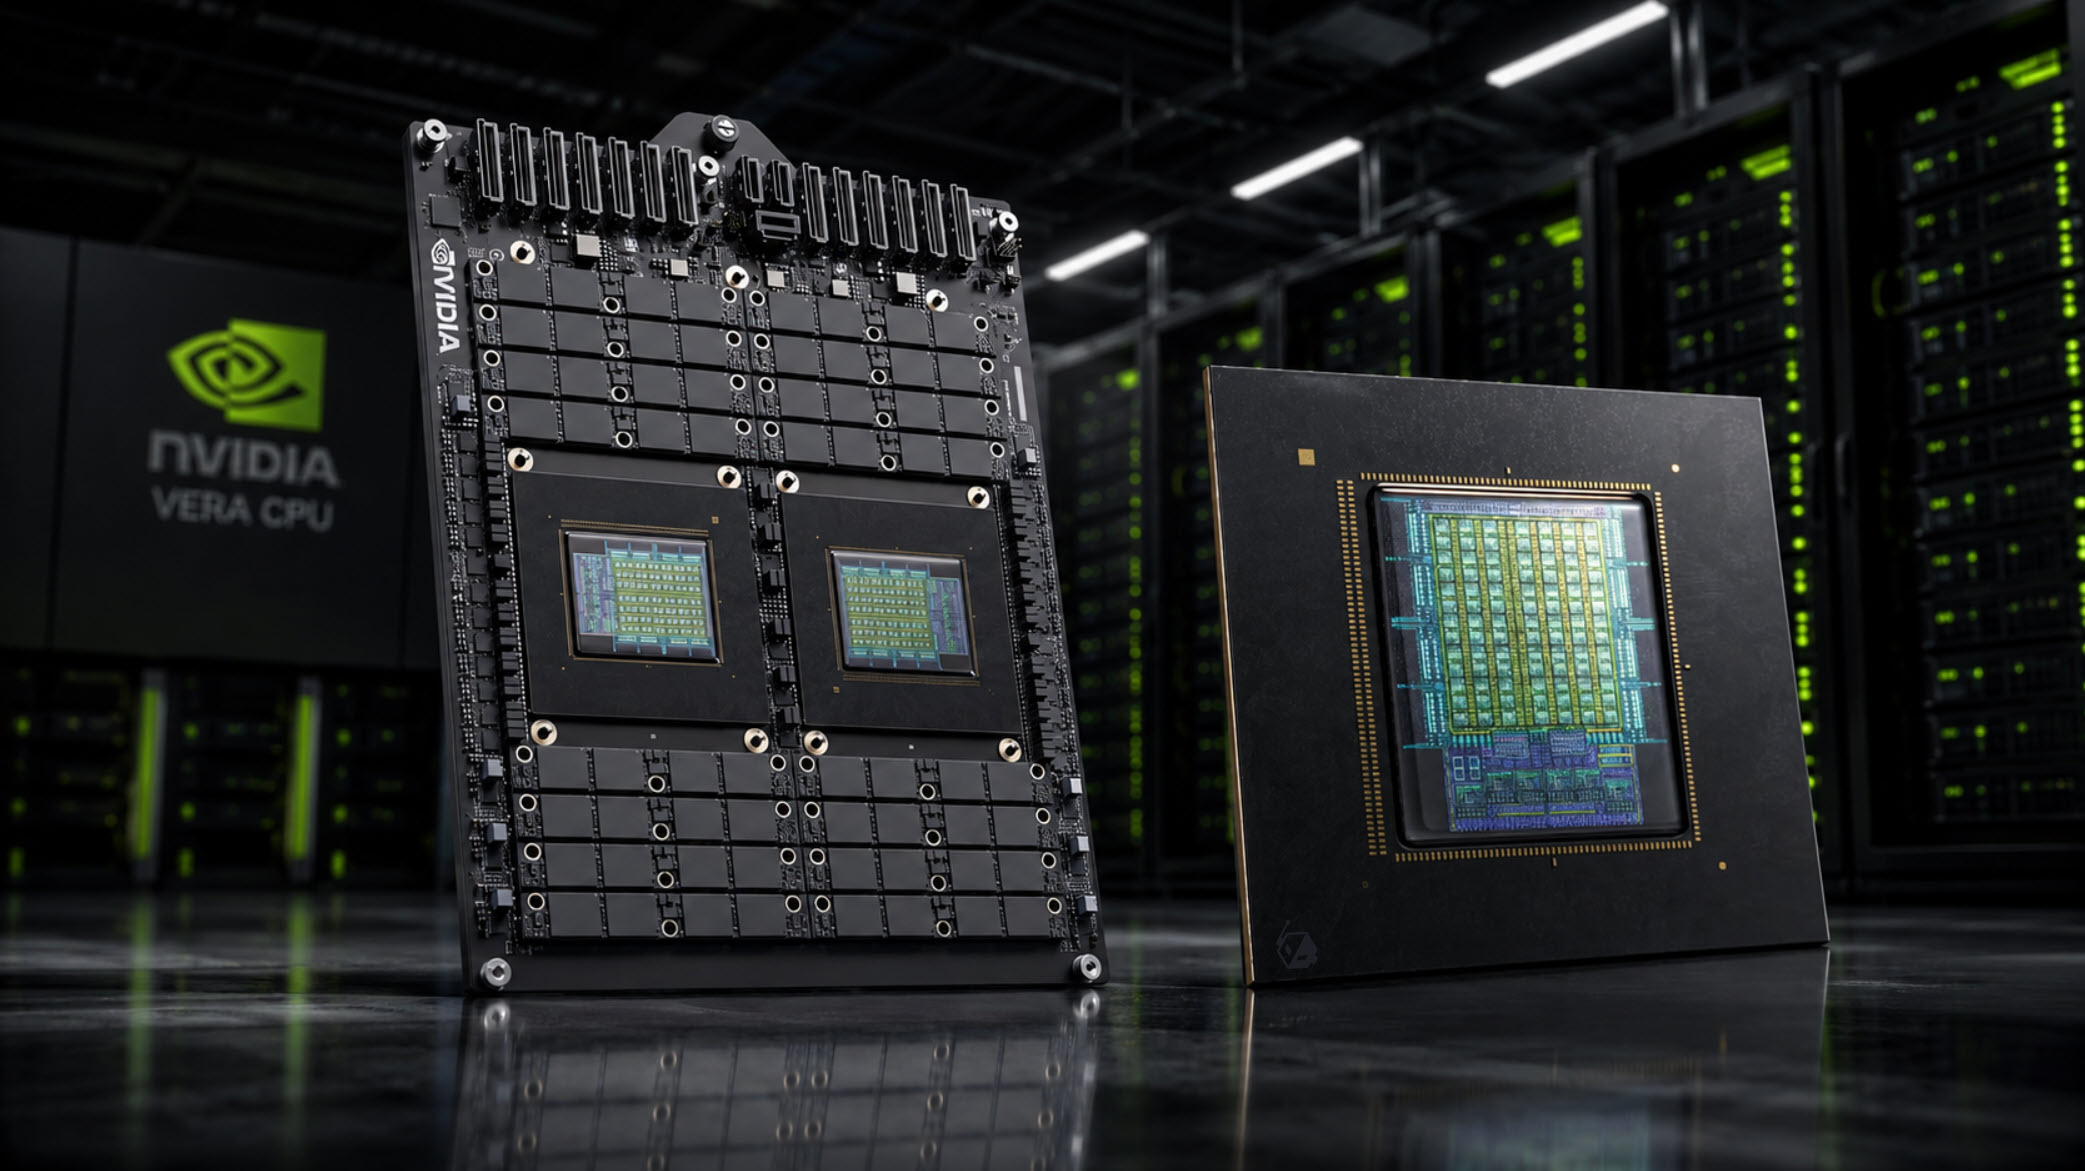
輝達Vera團隊接受訪問時表示,Vera正是基於這項變化打造,並選擇單體式裸晶(monolithic die)而不是近年主流的Chiplet設計,希望同時兼顧高單執行緒效能與高吞吐量。
雲端時代追求核心數 卻犧牲單核心效能
輝達指出,2010年代初期資料中心CPU主要追求單核心效能,例如當年的英特爾Haswell架構,核心數較少,但運作頻率與單執行緒效能較高。
隨著大型雲端服務商崛起,市場需求開始轉向「每台伺服器能塞進多少核心」,藉此提高單一伺服器可承載的工作量與收益。
為了提高核心密度並控制成本,x86處理器也逐漸由單一大型裸晶轉向Chiplet架構。
不過輝達認為,這種設計方向也讓單執行緒效能與每時脈指令數(IPC)受到犧牲。
AI代理讓CPU、GPU必須高速來回
代理式AI改變了這套邏輯。
AI代理執行工作時,會不斷在GPU推論與CPU序列工作之間切換,例如執行Python腳本、工具呼叫、程式碼編譯,再把結果送回GPU進行下一輪推理。
由於GPU仍是AI資料中心最昂貴的資源之一,CPU若處理得太慢,就會讓GPU處於等待狀態。
因此,輝達認為新一代CPU必須具備高單執行緒效能、高記憶體頻寬與低延遲,才能盡可能提高GPU利用率。
Vera因此採用高效能核心、客製化LPDDR5X記憶體子系統,以及第二代NVIDIA Scalable Coherent Fabric。
Vera捨棄Chiplet 改採單體式裸晶
Vera另一項重要設計,是使用單體式裸晶。
輝達表示,所有核心都位於同一塊運算裸晶上,因此晶片一端的核心與另一端核心通訊時,不需要跨越Chiplet之間的I/O邊界,可降低額外延遲。
輝達認為,過去x86業者必須同時兼顧消費型PC與資料中心等不同市場,因此需要更具彈性的架構。
相較之下,Vera可以完全針對高效能AI資料中心進行設計,不需要受到既有產品線限制。
Vera的二分頻寬(bisection bandwidth)達3.4TB/s,輝達宣稱約為目前領先x86晶片的3倍,可讓不同核心更快速共享資料與上下文。
不過,輝達並未完全否定Chiplet。團隊表示,未來仍會依不同市場與設計需求決定是否採用Chiplet,並沒有固定的架構路線。
Vera效能較Grace提高1.5倍
輝達表示,Vera整體效能約比前一代Grace快1.5倍。
針對AI代理常見的工作負載,例如Python執行與LLVM編譯,Vera相較目前領先x86處理器最高可達2倍效能,幾何平均則約領先1.6倍。
Vera也沒有採用傳統同步多執行緒(SMT),而是使用輝達自家的「空間多執行緒」(Spatial Multithreading)。
這項設計可以把不同執行緒分配成主要工作執行緒與I/O執行緒,避免系統負載升高時,I/O工作搶走主要運算執行緒的CPU週期。
輝達指出,第三方網站Phoronix近期測試顯示,Vera的空間多執行緒並未帶來效能負擔,反而可提高約20%效能。
AI代理甚至可能需要「純CPU機櫃」
輝達最初推出Grace CPU時,主要將CPU定位成GPU的Host Node,也就是負責替GPU提供資料與系統控制。
但隨著AI代理與強化學習工作量增加,輝達發現市場開始出現大量純CPU需求。
例如AI代理可能同時執行大量工具呼叫、沙盒任務與序列運算,甚至有業者單一客戶就需要運行40萬個沙盒環境。
因此,Vera不只會出現在Vera Rubin等CPU+GPU整合架構,也將獨立作為CPU銷售,甚至部署成整櫃Vera CPU,用於處理代理式AI與強化學習工作負載。
CPU與GPU比例可能開始往CPU傾斜
市場近期也開始討論,在AI代理大量普及後,CPU與GPU比例是否可能大幅改變,甚至出現80:1的極端情境。
輝達並未認同特定比例,也表示目前沒有正式預測。
不過Vera團隊承認,AI基礎設施的資源比例確實正在朝CPU方向移動。
這也是輝達積極強調Vera「代理式AI CPU」定位的原因,希望當市場開始部署大量獨立CPU機櫃時,Vera也能成為主要選項。
輝達認為,代理式AI正在改變過去十多年雲端資料中心追求「核心愈多愈好」的CPU設計方向。當GPU成為AI資料中心最昂貴的資產,CPU重新必須追求更快的單執行緒速度、更低延遲與更高資料移動效率,而Vera正是輝達針對這套新運算模式打造的CPU。
來源:wccftech