高通HBC矽晶片完成驗證 攻AI推論記憶體瓶頸
記者黃仁杰/編譯
高通宣布,第一代高頻寬運算(High Bandwidth Compute,HBC)矽晶片已在美國聖地牙哥實驗室完成驗證,並成功跑通完整記憶體讀寫路徑與近記憶體運算功能,為公司切入AI資料中心推論市場取得早期硬體成果。
這項HBC架構主要鎖定大型語言模型(LLM)推論的記憶體瓶頸。由於每生成一個Token,都需要把模型資料持續送往運算單元,當系統規模擴大後,資料搬移所帶來的延遲與功耗,將直接影響吞吐量與總體持有成本。
HBC把運算拉近記憶體
高通HBC的核心概念,是把運算單元進一步靠近記憶體,藉此降低資料搬移距離。
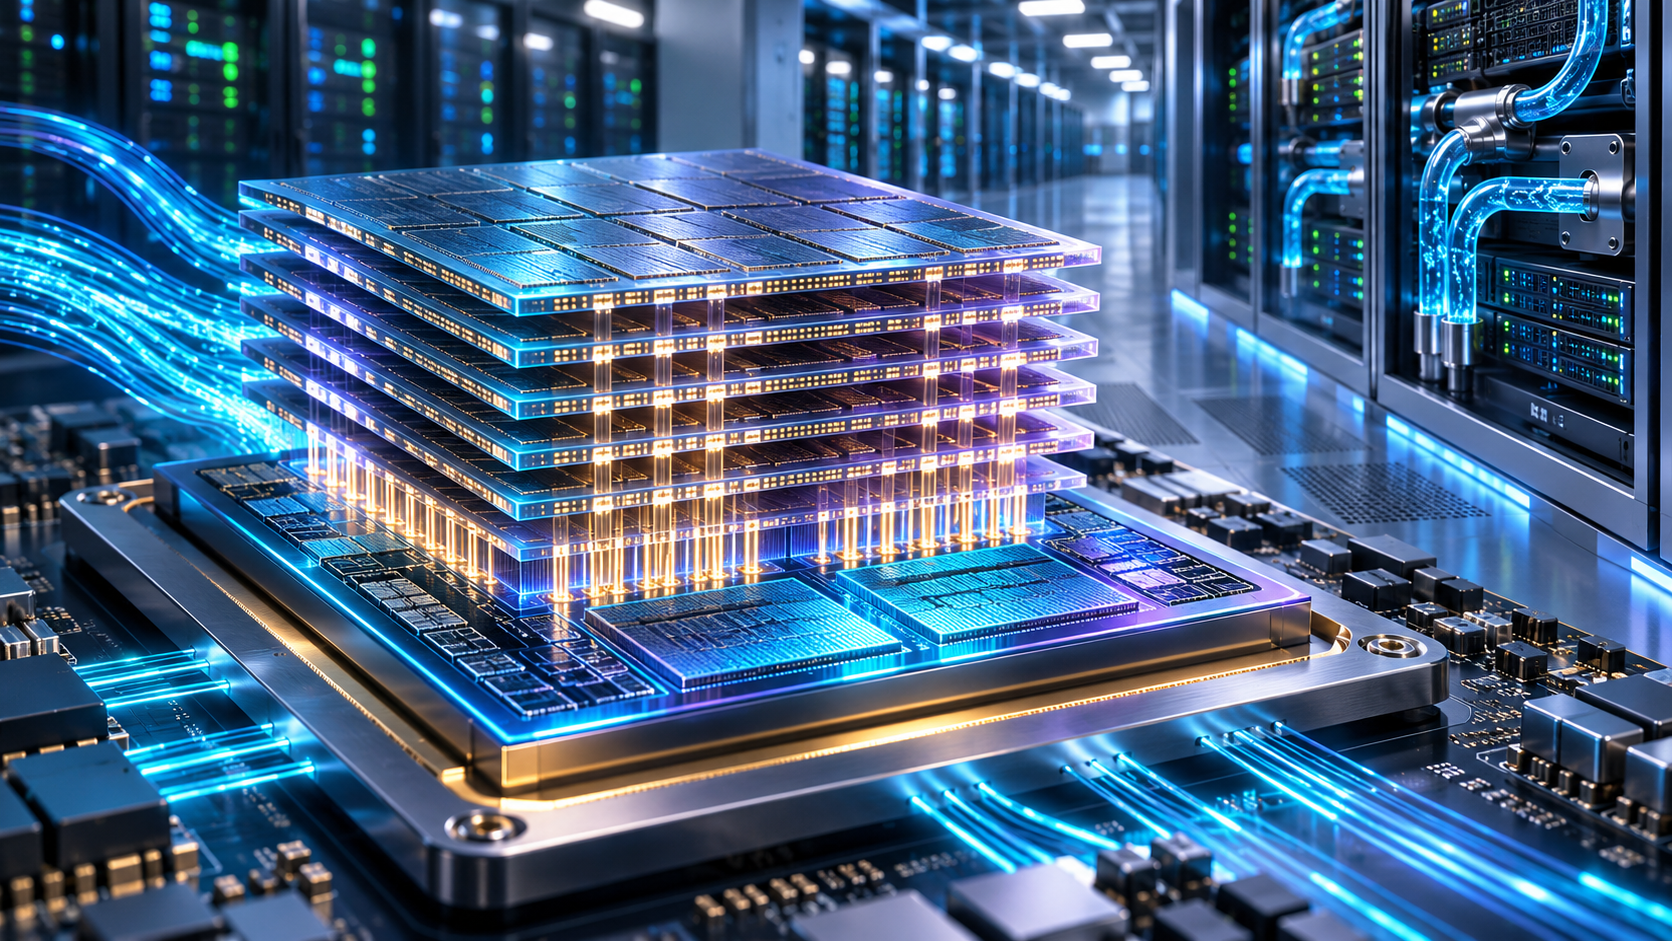
架構上,高通把低功耗LPDDR記憶體裸晶堆疊在主動式AI加速器Base Die上方,並透過晶圓對晶圓鍵合(wafer-to-wafer bonding)連接。
這讓資料傳輸距離由傳統架構的毫米等級,縮短至微米等級,藉此提高有效記憶體頻寬,同時降低資料搬移能耗。
高通目前實測結果顯示,HBC的有效記憶體頻寬約為LPDDR5X的18倍,每瓦可提供的頻寬則超過預估HBM4規格的5倍。
不過,後者略低於高通先前提出的6倍目標。
數據仍屬早期矽晶片測試結果
高通也特別說明,目前數據是依據實際矽晶片測量結果,再換算至目標運作條件,並與公開的競爭產品規格比較所得。
最終效能仍可能隨產品實作方式、工作負載與系統配置而有所不同。
這也意味目前結果主要證明HBC架構已能實際運作,但真正進入商用產品後的效能,仍需要等待後續獨立測試驗證。
加入冗餘與重新映射降低堆疊缺陷影響
高通目前正分階段推進HBC,包括架構設計、製程開發、測試晶片、矽晶片驗證與產品整合。
公司也已與晶圓代工及封裝合作夥伴共同驗證晶圓對晶圓鍵合技術。
由於多層記憶體與邏輯晶片垂直堆疊後,任何單一層缺陷都可能影響整體良率,高通也在HBC中加入冗餘與重新映射機制,讓系統可以避開故障記憶體區域。
高通同時強調,公司已累積超過10年的「記憶體直接堆疊於邏輯晶片」相關技術經驗,也曾參與JEDEC LPDDR標準制定。
目前測試晶片採用兩層DRAM堆疊,未來商用產品則預計提高至四層。
Dragonfly AI250預計2027上半年送樣
首款採用HBC技術的資料中心產品Dragonfly AI250,預計在2027年上半年開始送樣,並整合進高通Dragonfly Rack AI推論基礎設施。
整套系統將採全液冷設計,單一機櫃可配置38.6TB記憶體,有效頻寬則達7.4PB/s。
高通也正同步擴大伺服器端布局,預計2027年推出採用Oryon架構的C1000伺服器CPU,之後在2028年再推出搭載下一代HBC的Dragonfly AI300。
從HBC到Dragonfly Rack,高通目前的方向相當明確,就是把過去在手機SoC、低功耗記憶體與CPU架構累積的技術,進一步帶進AI資料中心市場,並直接挑戰目前以HBM為核心的AI推論記憶體架構。
來源:wccftech