讓 Cosmos DB 的資料開口說話:攤平之後怎麼查?|專家論點【黃婉中】
作者:黃婉中(雲端架構師)
上篇聊到,Cosmos DB 這類資料庫天生是為 OLTP(處理單筆交易)設計的,想拿來做 OLAP(跨資料分析),需要先把巢狀資料反正規化成寬表。攤平之後,還有兩件事要決定:資料要放進什麼樣的資料庫、以及用什麼工具讓業務人員自然語言查詢。
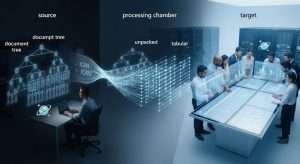
順帶一提,攤平不用另外建表、複製一份資料維護。微軟的 Fabric 是一套把資料整理、儲存、查詢、視覺化包在一起的分析平台,用它的 Mirroring 功能,Cosmos DB 資料同步過去後,可以直接下 query 把巢狀 JSON 展開,再用這段 query 建一個 view。View 不是實體資料,是存起來的查詢邏輯,不用寫 ETL,也不動 Cosmos DB 本身的結構。
除了表怎麼設計,資料庫本身也要跟著換
客戶後來又問了我一個問題:既然只是把表格設計改一下,那是不是隨便找個資料庫,把表改成上篇那樣就好,不用大費周章換資料庫?
「AI履歷健檢」看見自己優勢:https://campaign.1111.com.tw/resume-review/
更多科技工作請上科技專區:https://techplus.1111.com.tw/
這裡有一層容易被忽略的細節:反正規化只是改變表怎麼設計,但資料庫底層如何存資料,也會影響效能。
傳統 SQL 資料庫(像 PostgreSQL、MySQL)是列式儲存(row storage):同一筆記錄的所有欄位,實際存在硬碟上相鄰的位置。這對 OLTP 很合適,因為一筆交易通常要讀寫一整列的大部分欄位,例如結帳、更新個人資料,整列存在一起,一次讀寫就搞定。
但 OLAP 常見的查詢是「只挑幾個欄位,掃過幾百萬列」,例如上篇那張銷售事實表,只要「城市」跟「小計」這兩欄算加總,不需要其他欄位。如果資料是列式儲存,即使只要兩個欄位,硬碟還是得把整列讀出來才能挑出需要的部分,等於浪費大量讀取效能。這就是為什麼專門做 OLAP 的資料庫,用的是欄式儲存(columnar storage):把同一個欄位的資料集中存在一起,查詢時只讀取需要的欄位,大幅加快分析查詢的速度。
所以「要不要換成專門的欄式儲存資料庫」,是看兩個條件:
查詢形狀:如果使用情境是「掃過很多列、只看幾個欄位、要加總分組」,欄式儲存更快。
寫入方式:如果是批次匯入、寫入後很少逐筆修改(像這個客戶每天把 Cosmos DB 資料批次同步過來),欄式儲存更有優勢。
為什麼是 Fabric,不是自己組一套?
資料整理好,也放進合適的資料庫之後,接下來要決定的是:業務人員要用什麼工具,才能用自然語言查到答案。
客戶問我:如果重點是「把資料攤平」,那用 Microsoft AI Foundry 直接接 Cosmos DB,用 AI agent 現場處理,是不是也可以?
技術上走得通,Cosmos DB 的 SQL API 本身也能查巢狀 JSON。但差別在於:Cosmos DB 沒有Create view這種把查詢邏輯存成物件的功能,agent 每次都得現查。要把攤平邏輯固化成一個大家共用的 view,需要使用Fabric。Fabric 可以針對鏡射資料建 view,之後 Data Agent、Power BI 都直接查這個 view 就好。
選 Fabric,等於買了一套資料整理、儲存、查詢介面、視覺化全部包在一起的服務。攤平好的資料留在 OneLake 裡,Fabric Data Agent 直接查,要做報表就接 Power BI,中間不用再多想「這份資料該放哪個資料庫」。
如果選 Foundry,拿到的是查詢介面跟 AI 推理引擎,但資料整理完要放哪裡,得自己決定,可以放 Azure SQL、放 PostgreSQL,甚至最後還是得繞回 Fabric 的 OneLake。要做視覺化報表,還得另外接 Power BI 或別的工具。
有內部工程團隊、想要高度客製化的公司,可能會選 Foundry 自己組;沒有工程團隊、想要幾個月內上線的中小企業,買一套包好的服務,反而更划算。
給讀者的判斷框架
回頭看整件事,其實可以歸納成四個問題,遇到類似情境時可以拿來問自己:
- 我要做的是 OLTP 還是 OLAP? 查一筆資料 vs. 算一堆資料的加總,需要不同資料庫設計。
- 值不值得做反正規化? 這是一次性的整理成本,換取之後每次查詢都更快更準。如果查詢頻率低、資料結構單純,不一定要大費周章。
- 需不需要換成專門的欄式儲存? 看查詢的形狀(找特定一筆,還是掃很多列算加總)跟寫入的方式(頻繁單筆修改,還是批次匯入),不是單純看資料量大小。
- 要自己組,還是買整合服務? 沒有工程團隊、想快速上線,選整合服務;有能力客製化、想要更大的彈性,可以自己組。